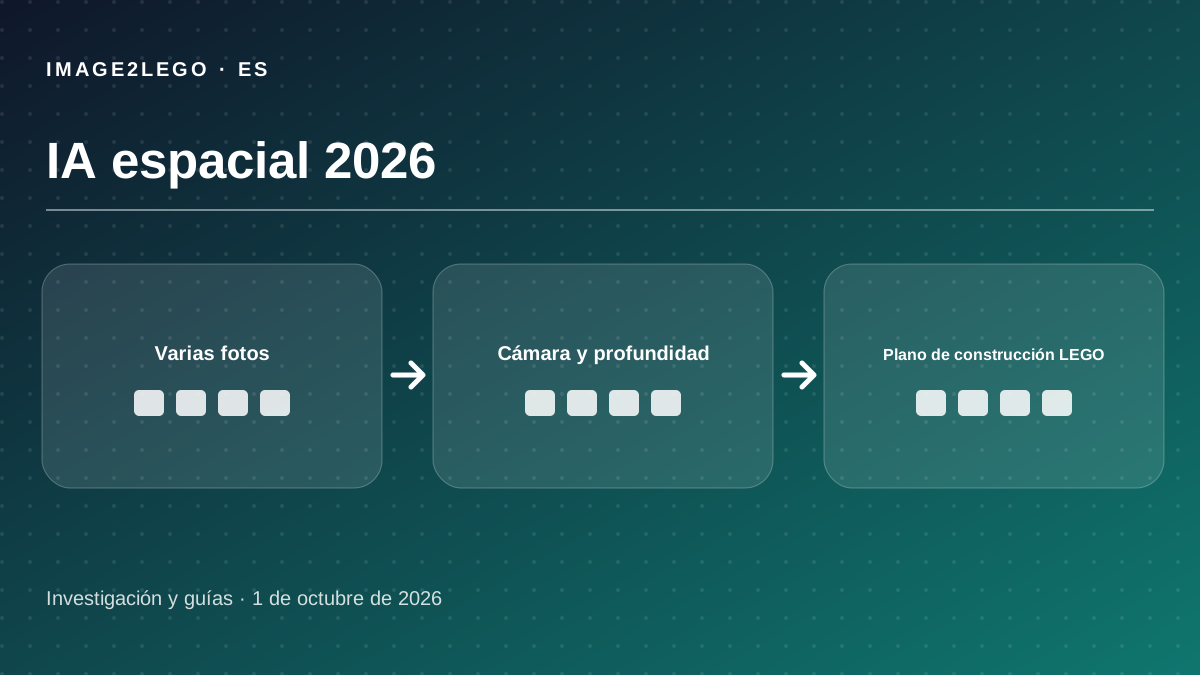
Las poses de la cámara ayudan a colocar varias fotografías en un sistema de coordenadas. La profundidad puede identificar qué detalles son protuberancias, huecos u objetos separados en lugar de simples sombras. La investigación citada es independiente de Image2LEGO; no afirmamos utilizar esos sistemas.
“Reconstruction is a powerful and scalable proxy task”
— VGGT-Ω project page and September 2026 update. Extracto breve de la fuente original; sus resultados no miden Image2LEGO.
Lo que añade VGGT-Ω
Dato de la fuenteEl equipo de Oxford y Meta dice VGGT-Ω mejora la reconstrucción estática y dinámica. La página de su proyecto informa un entrenamiento con aproximadamente el 30% del uso de memoria de GPU del predecesor y con 15 veces más datos supervisados. También informa una mejora del 77% con respecto a un resultado de estimación de cámara anterior en el punto de referencia Sintel. Estas son comparaciones de investigaciones publicadas, no cifras de rendimiento de Image2LEGO. [1] [2]
Análisis para modelos de bloquesLas poses de la cámara ayudan a colocar varias fotografías en un sistema de coordenadas. La profundidad puede identificar qué detalles son protuberancias, huecos u objetos separados en lugar de simples sombras.
Al fotografiar un objeto físico, recopile vistas frontales, laterales y traseras a una distancia similar. Superponga puntos de referencia visibles entre vistas.
Por qué es importante la actualización de septiembre
Dato de la fuenteEl 18 de septiembre de 2026, los autores publicaron un código de entrenamiento y un punto de control de una ejecución adicional. Dicen explícitamente que el nuevo punto de control debería ser la referencia para futuras comparaciones de los puntos de referencia informados. [1]
Análisis para modelos de bloquesUn artículo actual no debe repetir un punto de referencia titular sin su contexto de evaluación. Esto es importante especialmente cuando las afirmaciones de marketing convierten la puntuación de una investigación en una supuesta garantía para el flujo de trabajo del consumidor.
Si compara los sistemas de reconstrucción 3D, tenga en cuenta el punto de control, el conjunto de datos y las condiciones de la imagen. No infieras la capacidad de construcción de bloques a partir de la precisión de la cámara.
La reconstrucción 3D no es un montaje LEGO
Dato de la fuenteVGGT predice atributos 3D como parámetros de cámara, mapas de profundidad y mapas de puntos. La tarea de BrickNet es diferente: representar las relaciones entre las partes del bloque y sus conexiones. [2] [3]
Análisis para modelos de bloquesUna mejor geometría puede reducir las conjeturas sobre superficies invisibles, pero un diseño de bloque aún necesita dimensiones discretas, montantes, tubos, pasadores, controles de colisión y un orden de construcción. Esas restricciones no aparecen automáticamente en una nube de puntos.
Inspeccione si una torre generada tiene soporte interno y si las paredes se conectan entre capas, no solo si se parece a las fotos.
Cómo pueden utilizarlo los constructores de LEGO
Dato de la fuenteLa familia VGGT acepta una o múltiples vistas visuales; el repositorio original documenta las salidas de la cámara, la profundidad y el mapa de puntos. El rendimiento varía según la escena y la configuración. [1] [2]
Análisis para modelos de bloquesUn producto práctico podría utilizar la reconstrucción como guía para la proporción y la alineación de la cámara mientras le pide a una persona que resuelva la incertidumbre. Debería mostrar regiones de baja confianza en lugar de inventar una pared trasera que parezca segura.
Para sujetos simétricos, indique la simetría en el mensaje. Para sujetos asimétricos, proporcione una segunda vista en lugar de pedirle a la IA que adivine.
Preguntas frecuentes
¿VGGT-Ω convierte el video en instrucciones LEGO?
No. Es un sistema de reconstrucción. Se necesitan un gráfico de piezas separado, un pase de validación y un planificador de instrucciones.
¿Por qué usar varias fotos si la IA acepta una?
Las vistas adicionales pueden revelar superficies ocultas y reducir la ambigüedad, aunque la calidad de captura y la coherencia de la vista siguen siendo importantes.
Fuentes primarias y método editorial
Las capacidades y cifras de terceros se atribuyen a sus fuentes originales. El análisis sobre modelos de bloques y los consejos prácticos son inferencias editoriales, no funciones verificadas de Image2LEGO.
Fuentes revisadas el 1 de octubre de 2026. Los resultados de investigación dependen de los datos de prueba, el hardware, la versión del modelo y las imágenes utilizadas. Esta página traduce el artículo editorial en inglés.